我们需要什么样的具身模型
当前最简洁的具身模型定义是:
但最终目标显然不只是把图像回归成机械臂动作,而是希望机器人像成熟的 coding agent 一样,逐渐获得六类能力:
- Scaling law 成立:模型、数据和算力增加后,泛化能力能够稳定、可预测地提高。
- 高频控制:既具备高层语义能力,也能完成实时、连续、精细的操作。
- 持续学习与快速迁移:像 prompt、memory 和 skill 一样,通过少量演示迅速吸收新任务。
- Agentic reasoning:能规划、监督执行、定位 trajectory 中的错误,并主动纠正。
- 世界模型能力:理解三维空间、视角、动力学,以及动作会如何改变世界。
- 自主能力增长:能够在线探索、收集经验、形成技能,并逐渐完成训练分布之外的任务。
因此,真正的具身智能应该是一个能够感知、预测、行动、验证、适配和积累经验的闭环系统。
当前具身基模的主流技术栈
Pre-training
典型 VLA 可以概括为:
视觉语言模型负责语义和场景理解,action expert 使用 diffusion、flow matching 或其他生成式方式预测 action chunk。
这里所谓的 action expert 本身也是通过 imitation learning、SFT 学习示范数据的。它可以流畅地输出动作、完成任务,但这不等于理解任务、知道成功条件,或者能够判断自己是否做错。
WAM、world-action model 和 latent action model 则试图在 action prediction 之外加入状态变化建模,例如同时学习:
这相当于同时学习“动作造成什么后果”以及“为了产生某种变化应该采取什么动作”。这件事 make sense:我们当然要尝试学习世界的变化与动力学。
近期的一些代表工作包括:
- Atlas:World Labs 于 2026 年发布的多模态自回归扩散世界模型,将文本、图像、相机位姿和深度图组织成三维空间上下文,用于可控视角生成、三维重建、时空模拟和机器人 Real-to-Sim。
- Genie:Google DeepMind 的 Genie 系列从无动作标注视频中学习可控的 latent action 与环境演化,其中 Genie 3 可根据文本实时生成能够持续交互和导航的视觉世界,定位于开放式环境模拟与智能体训练。
- GEN-1.5:Generalist 的具身基础模型将一段 3–12 秒的传感器—动作示范放入约 30 秒上下文作为 physical prompt,在不更新参数的情况下生成 100 Hz 闭环动作,并展示了短程任务的一次示范学习、技能组合和仿真示范到真机迁移。
- Zero-WAM:Zero-WAM 将人类操作视频作为新任务的视觉 prompt,通过因果 video-action 建模联合预测机器人未来观察与可执行动作,使同一策略能够在不微调参数的情况下跟随视频完成训练时未见任务。
- Fast-WAM:Fast-WAM 在训练阶段利用未来视频预测学习动作相关的世界表征,在部署阶段跳过显式未来视频生成并直接输出动作,以此检验 WAM 的主要收益能否由训练时的世界建模保留,同时显著降低控制延迟。
Post-training 与推理
可能的 post-training 与部署适配手段包括:SFT 利用示范和纠正轨迹学习动作;RL 根据环境反馈优化成功率;on-policy distillation 由 teacher 标注 student 实际访问的状态;ICL 通过上下文示范即时条件化行为;TTT 在部署时更新 latent、adapter 或局部参数;continual learning 长期吸收新经验并抑制遗忘;teacher–student distillation 将慢速推理、世界预测或多次采样压缩为高速策略;one-shot/few-shot adaptation 则以极少演示完成任务、场景或 embodiment 迁移。这些方法可组合成“尝试—验证—更新—蒸馏—技能固化”的闭环。
Astra 与 MLLM Harness
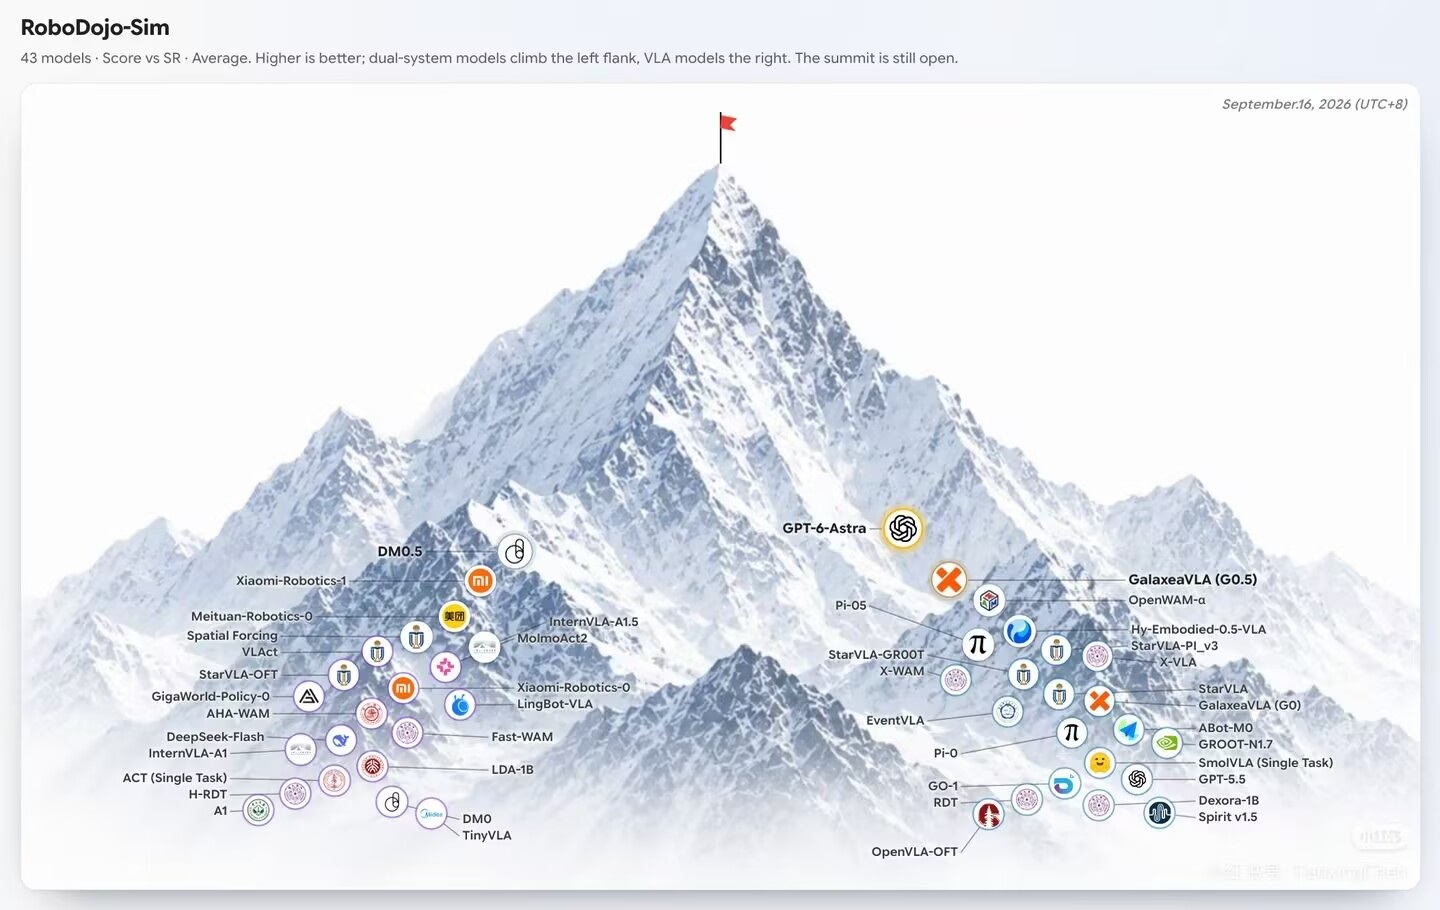
除了继续扩大 VLA/WAM 本体,另一条主流路线是把 Astra 这样的 frontier MLLM 放在 policy 外部作为 Harness。它们也许首先只是 tool:读取图像、视频和 execution trace,调用 perception、VLA、WAM、传统 controller 与代码工具,分解任务,并把 atomic skills 编排成长程行为。此时系统的能力不完全存在于某一个 end-to-end model 中,而存在于模型能否选择正确工具、组织 skill、检查结果并在失败后重新编排。
这里真正困难的是 control granularity 与 time scale。如果让 Astra 决定每一个 action,延迟、成本和动作稳定性都难以接受;如果只在任务开始时规划一次,它又无法处理接触误差、状态漂移和中途失败。更合理的层级可能是:controller 负责最高频的稳定控制,VLA 或 atomic skill 负责局部闭环,Astra 在 task decomposition、subgoal transition、高不确定状态和 repeated failure 时介入。何时触发、一次决定多长 horizon、哪些观察返回上层,以及怎样把一次成功编译回更快的 skill,都会直接决定 Harness 是否真的有用。
即使 Astra 目前不适合作为高频 system 1,它仍代表我们现在能够 reach 的 intelligence ceiling。它的价值不仅是直接控制机器人,也可以作为 probe、teacher、task constructor、verifier 和 skill compiler:先用最高智能探索系统能够做到什么,再把反复出现的 reasoning、纠正和工具调用蒸馏进更快、更便宜的 policy。问题因而不是“它是不是机器人模型”,而是怎样把这个智能上限接入具身系统,同时不让速度与用量吞掉收益。
ICL、TTT 与具身技能适配
HOST、Zero-WAM、WAM-TTT 等工作集中强调 ICL、TTT 与 one-shot,说明研究重点正从训练固定 policy 转向让预训练基模在部署时吸收当前任务、场景和机器人信息,从而降低新技能的习得成本。ICL 保持参数基本不变,根据示范和交互历史条件化行为;TTT 利用测试时数据更新 adapter、latent、memory、normalization 或局部参数;retrieval 检索已有轨迹与原子技能;system identification 从少量交互估计动力学和控制特性;online fine-tuning 则持续修改策略。
演示轨迹、历史交互和技能库正在承担具身系统中的 prompt、context 与 skill。一条 demonstration 同时包含:
因此,one-shot 既提供任务提示,也可能隐式完成相机、机器人形态、控制频率和动力学适配。可复用 skill 还应包含 precondition、closed-loop controller、termination condition、success verifier 与 failure recovery。Generated video 可以提供视觉目标或运动先验,但仍需经过 correspondence、motion intent、robot-compatible action 和 closed-loop correction,才能转化为可执行技能。理想闭环是:
为什么 ICL 与 TTT 集中兴起
乐观来看,具身基模已经形成可组合的视觉、动作和动力学先验,少量现场信息即可激活新能力;谨慎来看,这也可能说明离线 policy 与真实部署环境之间仍存在巨大 domain gap,需要现场适配维持性能。判断其价值不能只看一次 one-shot 成功,还应测试跨任务、跨布局和跨 embodiment 迁移,确认模型利用了动作后果而非视觉匹配,检查适配是否破坏旧能力,以及失败经验能否沉淀为稳定技能。
TTT 还需处理灾难遗忘与错误更新。可采用 episodic adapter、embodiment-specific LoRA、latent adaptation、replay、trust region、update gating 或 episode 后 reset;短期经验先进入临时 memory,只有经过 success verifier 验证、能够重复成功且不导致旧技能明显回归的更新,才写入长期模型或技能库。
Harness 与 CaP:智能的 shortcut 与必由之路
VLA/WAM 提供连续感知与动作能力,Harness 将其组织成可检查、可组合、可持续更新的具身 Agent。近期的 OpenETA、CaP-X、ASPIRE、RoboHarness 与 RoboRSI 逐渐形成了一套共同范式:MLLM 负责任务分解、策略路由、视觉归因和程序修订,VLA、传统控制器与代码技能负责执行,视频、动作、工具调用、日志和成功判据构成可回放的 execution trace。
RoboRSI 提供了一个较成熟的具身 Harness 范例:它用自顶向下的技能树组织 Task、Compound Skill、Atomic Task 和 Base Skill,并让执行结果沿调用链返回具体责任节点。这样的结构使失败可追踪、技能可替换、稳定流程可固化,也为后续学习提供了明确的数据归属。
Coding agent 也可以成为 world builder
这里还有一个很自然的角色:Astra 不只在 rollout 上方充当 supervisor,也可以像 coding agent 一样直接构建 scene、environment 和 task,编写 reward、success verifier 与数据管线,再根据 policy 的真实失败修改场景、任务难度和 curriculum。类似 AgentWorld 中世界随 agent 一起生长的想法,放到具身系统里,environment 不再只是一次性搭好的 benchmark,而是训练闭环中可以持续被编程、验证和扩展的一部分。
这比“LLM supervise VLA”多了一层:上层模型既组织 policy,也组织 policy 所处的世界。它可以从真实场景建立可交互的仿真版本,批量生成相邻任务和反例,把 rollout 中暴露的能力缺口转化成新的训练 setting;验证过的策略再回到真实机器人,产生新的偏差与失败。所谓 growing and evolving,至少应同时发生在 environment、task、data、verifier 和 policy 上,而不是只让一个固定 policy 在越来越多的静态场景中训练。
对我而言,具身 RSI 更重要的标准是 OOD 条件下能力边界能否持续扩张。组合泛化意味着同一组 atomic skills 能够面向新物体、新场景和新任务顺序重新编排;MLLM Harness 通过显式任务结构、技能接口和执行历史,在这一点上具有明显的结构优势。Zero-WAM 等工作进一步说明,新任务可以通过人类视频进入模型的 context;RSI 需要继续回答,这次临时成功能否被诊断、验证并固化为下一次可直接复用的能力。
一个更直接的实验是:给机器人一个 OOD 任务,同时人为制造不同类型的能力缺口——完全移除某个必要 atomic skill、保留技能但让 Planner 无法正确组合,或者提供一个在当前 embodiment 上持续失败的技能。系统应根据观察、调用链和物理结果判断缺少的是任务规划、感知、动作数据、接触控制、动力学经验,还是 embodiment adaptation,并自主选择重新规划、检索经验、请求人类演示、进行 ICL、使用纠正轨迹微调,或在安全约束下自主练习。
例如,在插电任务中移除 insert skill,只提供定位、抓取、移动和基础力控;另一种设置则提供从其他机器人迁移来的 insert skill,使其在当前本体上连续失败。真正关键的问题是,模型能否识别“现有能力无法完成接触对准”,随后请求一次演示、收集少量纠正轨迹,或通过受限探索习得新的插入策略,最终把它固化为可跨插座、位置和物体复用的 atomic skill。如果只是把同一个任务做得更好,离能力增长还差一步。
评价重点应放在新任务覆盖、能力缺口归因、time-to-competence、人类演示成本、自主探索次数、旧技能回归和跨 setting 复用。这样才能判断系统是否真正获得了新能力。
速度仍然是这条路线的基础约束。高频动作由 VLA、控制器或固化代码执行,MLLM 在任务切换、技能失败和高不确定状态下触发;除单步推理延迟外,还应报告从发现能力缺口到获得稳定技能的总墙钟时间。具身 RSI 的效率最终体现在:机器人遇到下一项 OOD 任务时,需要的人类时间、真实 rollouts 和在线推理开销持续下降。
我们对具身 Scaling Law 的理解
具身 scaling law 大概率存在,但其核心自变量不应是原始 trajectory 数量,而应是经过物理对齐、任务相关性加权、具有新状态覆盖并包含闭环反馈的有效交互经验:
其中,qi 表示示范与控制质量,ai 表示动作坐标、控制频率、传感器和 embodiment 的对齐程度,ri(T) 表示相对于目标任务的相关性,ni 衡量数据是否覆盖新状态,fi 衡量是否包含失败、纠正、reward 与动作后果,Imixture 则表示不同数据源之间的冲突和负迁移。具身数据不能直接类比语言 token:同一个动作数值在不同机器人、坐标系或控制频率下可能具有完全不同的物理含义。
因此,多样性只有被模型正确条件化时才具有价值。任务、物体、场景、几何、动力学以及失败恢复的多样性,可以提供组合泛化所需的监督;操作者风格、速度、action convention 和 embodiment 的差异如果没有显式标识,则可能使相似观测对应互相冲突的动作标签。被建模的多样性构成能力覆盖,未被条件化的多样性往往表现为噪声。
“按照现有 VLA 范式再收十年数据也不够”的批评因此有一定道理。success-only offline imitation 主要增加专家轨迹附近的采样密度,却很少告诉模型错误动作会造成什么后果、偏离分布后如何恢复、长程任务在哪一步失败,以及什么交互最能降低当前不确定性。
具身 scaling 需要同时发生在四条轴上:VLM、互联网数据和人类视频带来的语义 scaling;对齐后的真实或仿真交互带来的物理 scaling;ICL、TTT 与 system identification 带来的快速适配 scaling;on-policy rollout、RL、纠正数据和自主探索带来的经验 scaling。真正的拐点将出现在能力与数据形成闭环之后:模型越强,越能识别自己的不确定性与能力缺口,主动收集高信息量经验;这些经验又继续提升模型,使数据生产本身随模型能力共同扩展。
机器人世界缺少自己的 tokenizer 与 ISA
当前跨 embodiment 学习的一个深层障碍,是不同厂商没有统一:
- 关节定义;
- 坐标系;
- position/velocity/torque 接口;
- 控制频率;
- 时间戳;
- 延迟;
- gripper 语义;
- proprioception;
- 相机标定;
- 安全控制。
因此,大模型经常被迫用几十亿参数猜测不同厂商的驱动协议。
理想系统应当存在一种 Robot Action IR:
这个 IR 不应只是七维动作向量,而可以包含:
厂商底层电机仍可不同,但模型共享中间层的物理动作语义。
这可能是具身世界的 tokenizer、ISA 或 USB-C:它不能消除摩擦、负载、延迟和动力学差异,却能把“任务学习”与“驱动协议适配”分开。剩余差异再通过 calibration、system identification 和 embodiment adapter 解决。
对当前具身模型叙事的几个 insight
Diffusion 的收益不能直接归因于“多模态动作分布”
Diffusion Policy 将 diffusion 的优势解释为能够表达 multimodal action distribution,但后续研究表明,性能提升未必主要来自多模态建模。Pan et al. 在 Much Ado About Noising 中控制网络结构、训练方式和推理计算后发现,普通 regression policy 可以达到与 generative policy 接近的性能;关键因素更多来自迭代式监督计算、随机扰动带来的正则化,以及避免直接回归产生的平均化动作。两步回归方法 MIP 也能匹配 flow-based policy。因此,验证 diffusion 的“多模态性”需要证明不同采样对应语义不同、稳定且均可成功的策略,例如从不同方向抓取或采用不同避障路径,而非轨迹抖动或单一模式附近的随机变化。
参考:Diffusion Policy;Much Ado About Noising, ICLR 2026。
Module 的贡献必须建立在 fully tuned baseline 上
复杂结构可能受益于额外参数、辅助监督、训练预算和更充分的调参,而不一定来自其宣称的机制。Luo et al. 研究 POMDP 中的 recurrent policy 时发现,仅为 context encoder 设置独立且更小的 learning rate,就能显著稳定训练,并超过若干加入 auxiliary prediction、显式历史特征或专门 memory mechanism 的方法。类似地,Ni et al. 通过系统优化 architecture、history representation 和 hyperparameters,使简单 recurrent model-free baseline 在 21 个环境中的 18 个达到或超过更复杂的方法。因此,semantic head、future predictor、world guidance 或 memory module 应在 matched-parameter、matched-compute、matched-data 和 matched-search-budget 条件下比较,并通过移除推理输入、替换监督目标和冻结模块等消融确认真正的因果来源。
参考:Luo et al., NeurIPS 2024;Ni et al., ICML 2022。
World model 的价值应由决策能力衡量
生成视频的清晰度只能反映部分视觉建模能力。机器人真正需要的是保持物体身份、几何结构、遮挡关系、接触状态和动作条件下的未来一致性。模糊画面仍可能包含对控制有用的低频几何与动力学信息;如果同时出现物体漂移、穿透、接触关系错误或跨视角不一致,则说明世界状态建模本身出现了问题。更直接的评测方式是让模型比较多个候选动作的后果,预测成功、碰撞和不可逆失败,并检验 world prediction 是否提高 OOD success rate、减少真实 rollouts、改善 recovery,或能否蒸馏为更好的 action policy。只有当未来表示对动作选择产生可验证的增益时,world model 才超越了 video generation。
仿真需要的不是统一的“真实”,而是 task-relevant physics
Coding agent 开始自动搭环境之后,一个绕不开的问题是:物理到底需要多真?我更倾向于把它写成一个 task-dependent 的预算,而不是追求单一的 photorealism 或 physics fidelity。语义搜索、物体计数和任务顺序主要依赖视觉与空间关系,光照、纹理、背景和相机可以大规模扰动;普通 pick-and-place 需要几何、碰撞、可达性和大致摩擦正确;插入、旋拧、折叠、液体与双臂协作则会迅速依赖接触、顺应性、受力、摩擦、时延和控制器响应。只要某种误差不会改变 optimal action、success boundary 或主要 failure mode,它就可以近似甚至随机化;一旦会改变这些量,就不能只靠“看起来像”来替代。
人能看出画面中的光、风或物体运动不自然,并不等于那就是机器人最在意的错误;反过来,人眼看不出的夹爪时延、刚度、质心、传感器同步和接触模型偏差,可能直接使 policy 失败。因而更有意义的检验不是问 sim 是否骗过人,而是看 sim 与 real 中的动作排序、状态转移、成功判定和恢复策略是否保持一致。真实世界负责暴露仿真不知道的部分,仿真负责把已经识别出的因果因素大规模展开。
“模型不知道自己在做什么”需要转化为可检验能力
当前 VLA/WAM 可能完成短程操作,却未必显式表示任务阶段、成功条件、失败原因、目标可达性和下一步所需能力。这形成了与 SayCan 类系统的反差:早期系统的低层动作能力有限,但会利用语言模型进行任务分解和 affordance ranking;今天的端到端策略动作更强,任务状态与语义判断却常被压入难以检查的 latent representation。语言解释本身并非充分标准,更有效的测试包括:面对不可能指令能否拒绝或澄清;关键物体缺失时能否重新规划;执行偏离后能否定位失败步骤;环境受到干预时能否更新计划;缺少某个原子技能时能否识别 capability gap,并选择检索、请求演示、安全探索或微调。这里衡量的是可干预的任务理解、反事实判断和自主恢复能力。
同样,拥有 semantic label、instruction 或阶段序号,也不等于模型知道自己在做什么。它可能准确预测“第三步”或复述“把杯子放进托盘”,却不知道这个阶段为什么成立、哪一个状态变化构成完成、动作何时已经不可恢复。可以通过移除关键物体、交换空间关系、重新编号步骤、从部分完成状态开始、加入中途扰动、构造不可能任务,或者让视觉表象与 success detector 冲突来测试这种 grounding。真正的 semantic 应把 instruction、task predicate、world state、action consequence 与 success 连成可被干预的闭环。
我们真正感兴趣的研究方向
VLA/WAM 的 Deployment-time Post-training
研究机器人如何利用部署现场产生的少量示范、失败轨迹和环境反馈快速获得新能力。系统可以先通过 ICL 在 context 中尝试任务,再根据执行结果进行 TTT、on-policy distillation、局部 SFT 或 RL,并将验证成功的经验固化为 adapter、policy update 或长期 skill。重点在于建立从临时适配到持续学习的完整路径,同时控制错误更新、distribution drift 和灾难遗忘。实验应区分模型究竟完成了任务复现、场景适配、embodiment adaptation,还是获得了能够跨物体和布局复用的新能力。
具身基模 Harness
在 VLA/WAM executor 外构建由 MLLM supervisor、memory、planner、skill library、verifier 和 recovery mechanism 组成的执行系统。MLLM 除了理解开放世界指令、分解任务和选择技能,也可以编写或修改 environment、task、reward、success condition 与数据生成代码;VLA 负责高频闭环控制,WAM 提供动作后果预测,verifier 判断阶段性成功并触发恢复。Harness 的价值在于把长程任务拆成可追踪的状态转换,使失败能够定位到 perception、planning、skill selection、environment mismatch 或 control。研究中需要记录完整 trace,明确自优化实际修改的是 prompt、memory、plan、环境、代码、skill、adapter 还是模型权重,并测量这些修改能否提高 OOD、恢复与长期任务能力。
Environment、task 与 policy 的共同生长
让 coding agent 根据 rollout 自动生成相邻任务、能力缺口测试和难度递增的 curriculum,再用 RL、OPD 或纠正数据提升 policy;当 policy 跨过当前 success boundary 后,agent 继续修改场景、物理参数、目标组合与失败条件。关键不是自动生成很多 task,而是新 task 能否稳定揭示当前 policy 的边界,reward 与 verifier 是否可信,新增数据是否带来可复用能力,以及真实部署暴露的 gap 能否回流到下一轮 environment。只有这些环节一起更新,才更接近 environment–policy co-evolution,而不是静态 benchmark 上的重复 rollout。
MLLM、CaP、VLA 与 WAM 的 Cross-teaching
不同模型可以构成互补的 teacher–student 系统。MLLM/CaP 提供任务分解、semantic subgoal、程序结构、成功判断、数据筛选和 trajectory annotation;WAM 预测候选动作的未来后果,为策略提供 counterfactual supervision;VLA 则承担低延迟闭环执行。训练时可以由慢模型为 student 的 on-policy states 提供标注,通过 OPD、SFT 或 preference learning 修正实际分布中的错误,再将规划、视频预测和多次采样压缩进高速 action model。
但 teaching 不应只有 MLLM → VLA。VLA 和真实机器人可能拥有语言模型缺少的低层 physical prior:什么姿态可达、哪种接触会滑、动作何时不稳定、控制器在多大延迟下会失效。它不必先把这些知识翻译成一段漂亮的语言解释,而可以通过 candidate-action ranking、subgoal reachability、action uncertainty、contact outcome、预测状态与真实状态的 residual,以及重复失败的聚类反馈给 Astra、planner 或 WAM。上层模型如果会据此改变计划、任务和环境,就形成了 VLA → MLLM/WAM 的反向 teaching,而不只是更强的 LLM 单向监督 action model。
Embodied Action IR
研究一种位于语义任务与机器人原生控制之间的跨 embodiment 动作中间表示。它可以描述末端位姿变化、接触模式、受力意图、关键点约束、阶段终止条件和允许的运动区域,再由小型 embodiment adapter 映射为不同机器人的关节、夹爪与控制指令。这样,主模型和高层技能可以跨机器人共享,新平台只需少量 calibration、system identification 与动作对齐。评价应覆盖跨机器人 zero/few-shot transfer、adapter 大小、校准数据成本、控制精度、旧机器人能力回归,以及增加新 embodiment 后能否由负迁移转化为正迁移。
高频控制与昂贵推理的分层
让高速 VLA 或 reactive policy 负责常规闭环控制,仅在 OOD、高不确定性、连续失败、任务切换或需要长程规划时调用 WAM、MLLM 或 CaP。慢速模型可以生成候选未来、比较动作后果、重新规划并提供纠正轨迹;验证成功后,再通过 distillation 或 OPD 将新策略压缩回高速 action model。系统还可以使用 diffusion cache、agent KV cache、latent reuse 和异步预测降低重复计算。最终评价需要同时考虑任务成功率、触发准确率、控制频率、端到端延迟、昂贵模型调用次数,以及蒸馏后脱离 teacher 独立执行的能力。
在我们目前能拿到的模型里,Astra 可以作为最高智能的一档来探测能力上限,但问题始终是 at what cost,以及 how to solve。除了成功率,我们最近更关心它的速度、用量、physical intuition、agentic ability 和跨 setting 泛化;成本则应包括每个 episode 的模型调用、token/API 开销、仿真与 GPU 墙钟时间、人工修复次数、从描述到可验证 task 的时间,以及获得一个可复用 skill 的总成本。更合理的系统不是 everywhere Astra:让它处理 first build、未知状态和高不确定决策,让更便宜的模型负责批量检查,让 VLA 与 controller 负责高频执行,再把反复出现的 reasoning 编译成环境代码、verifier、skill 或 student weights。
接下来怎样获得真正的理解
做研究当然可以先有判断,但最后还是要靠自己跑出来。现在很多 benchmark 的任务短、场景固定,不同范式可能都能刷出相近的成功率,很难据此判断 VLA、WAM、ICL、TTT 和 CaP 究竟学到了什么。因此,我们暂时也不必急着批评 CaP 只是 shortcut、MLLM 一定太慢、world model 只是在生成视频,或端到端 VLA 完全不理解任务。逐步复现、设计 probe,为自己的每个问题进行验证,才是好的研究方式。